“Ein Agent produziert in zwanzig Minuten mehr, als Du an einem Tag lesen kannst. Was willst Du da hinten noch abnehmen?” (Richard Seidl)
Vor einem Monat saß ich mit einem Team zusammen. Sie wollten herausfinden, wo agentische QA in ihren Prozess passt. Bis dahin gab es nur Diskussionen und ein weißes Blatt. Die Frage war zu vielschichtig.
Also haben wir das Blatt weggelegt und sind ihre Painpoints durchgegangen. Wo geht regelmäßig was schief? Was fällt immer erst in der Abnahme auf? Wo macht ihr dieselbe Nacharbeit zum dritten Mal? Und auch: Was läuft schon so reif, dass es auf die nächste Stufe gehoben werden kann? Nach einem Tag war das Whiteboard voll und es gab eine Liste mit den nächsten Schritten. Der Fokus auf den Prozess hat den Knoten gelöst.
Darin steckt für mich der Knackpunkt. Wir haben oft noch das große Test-Gate am Ende im Kopf. Fertig bauen, dann prüfen, dann Stempel drauf. Nur: Was willst Du bei diesem Tempo am Ende überhaupt noch abnehmen?
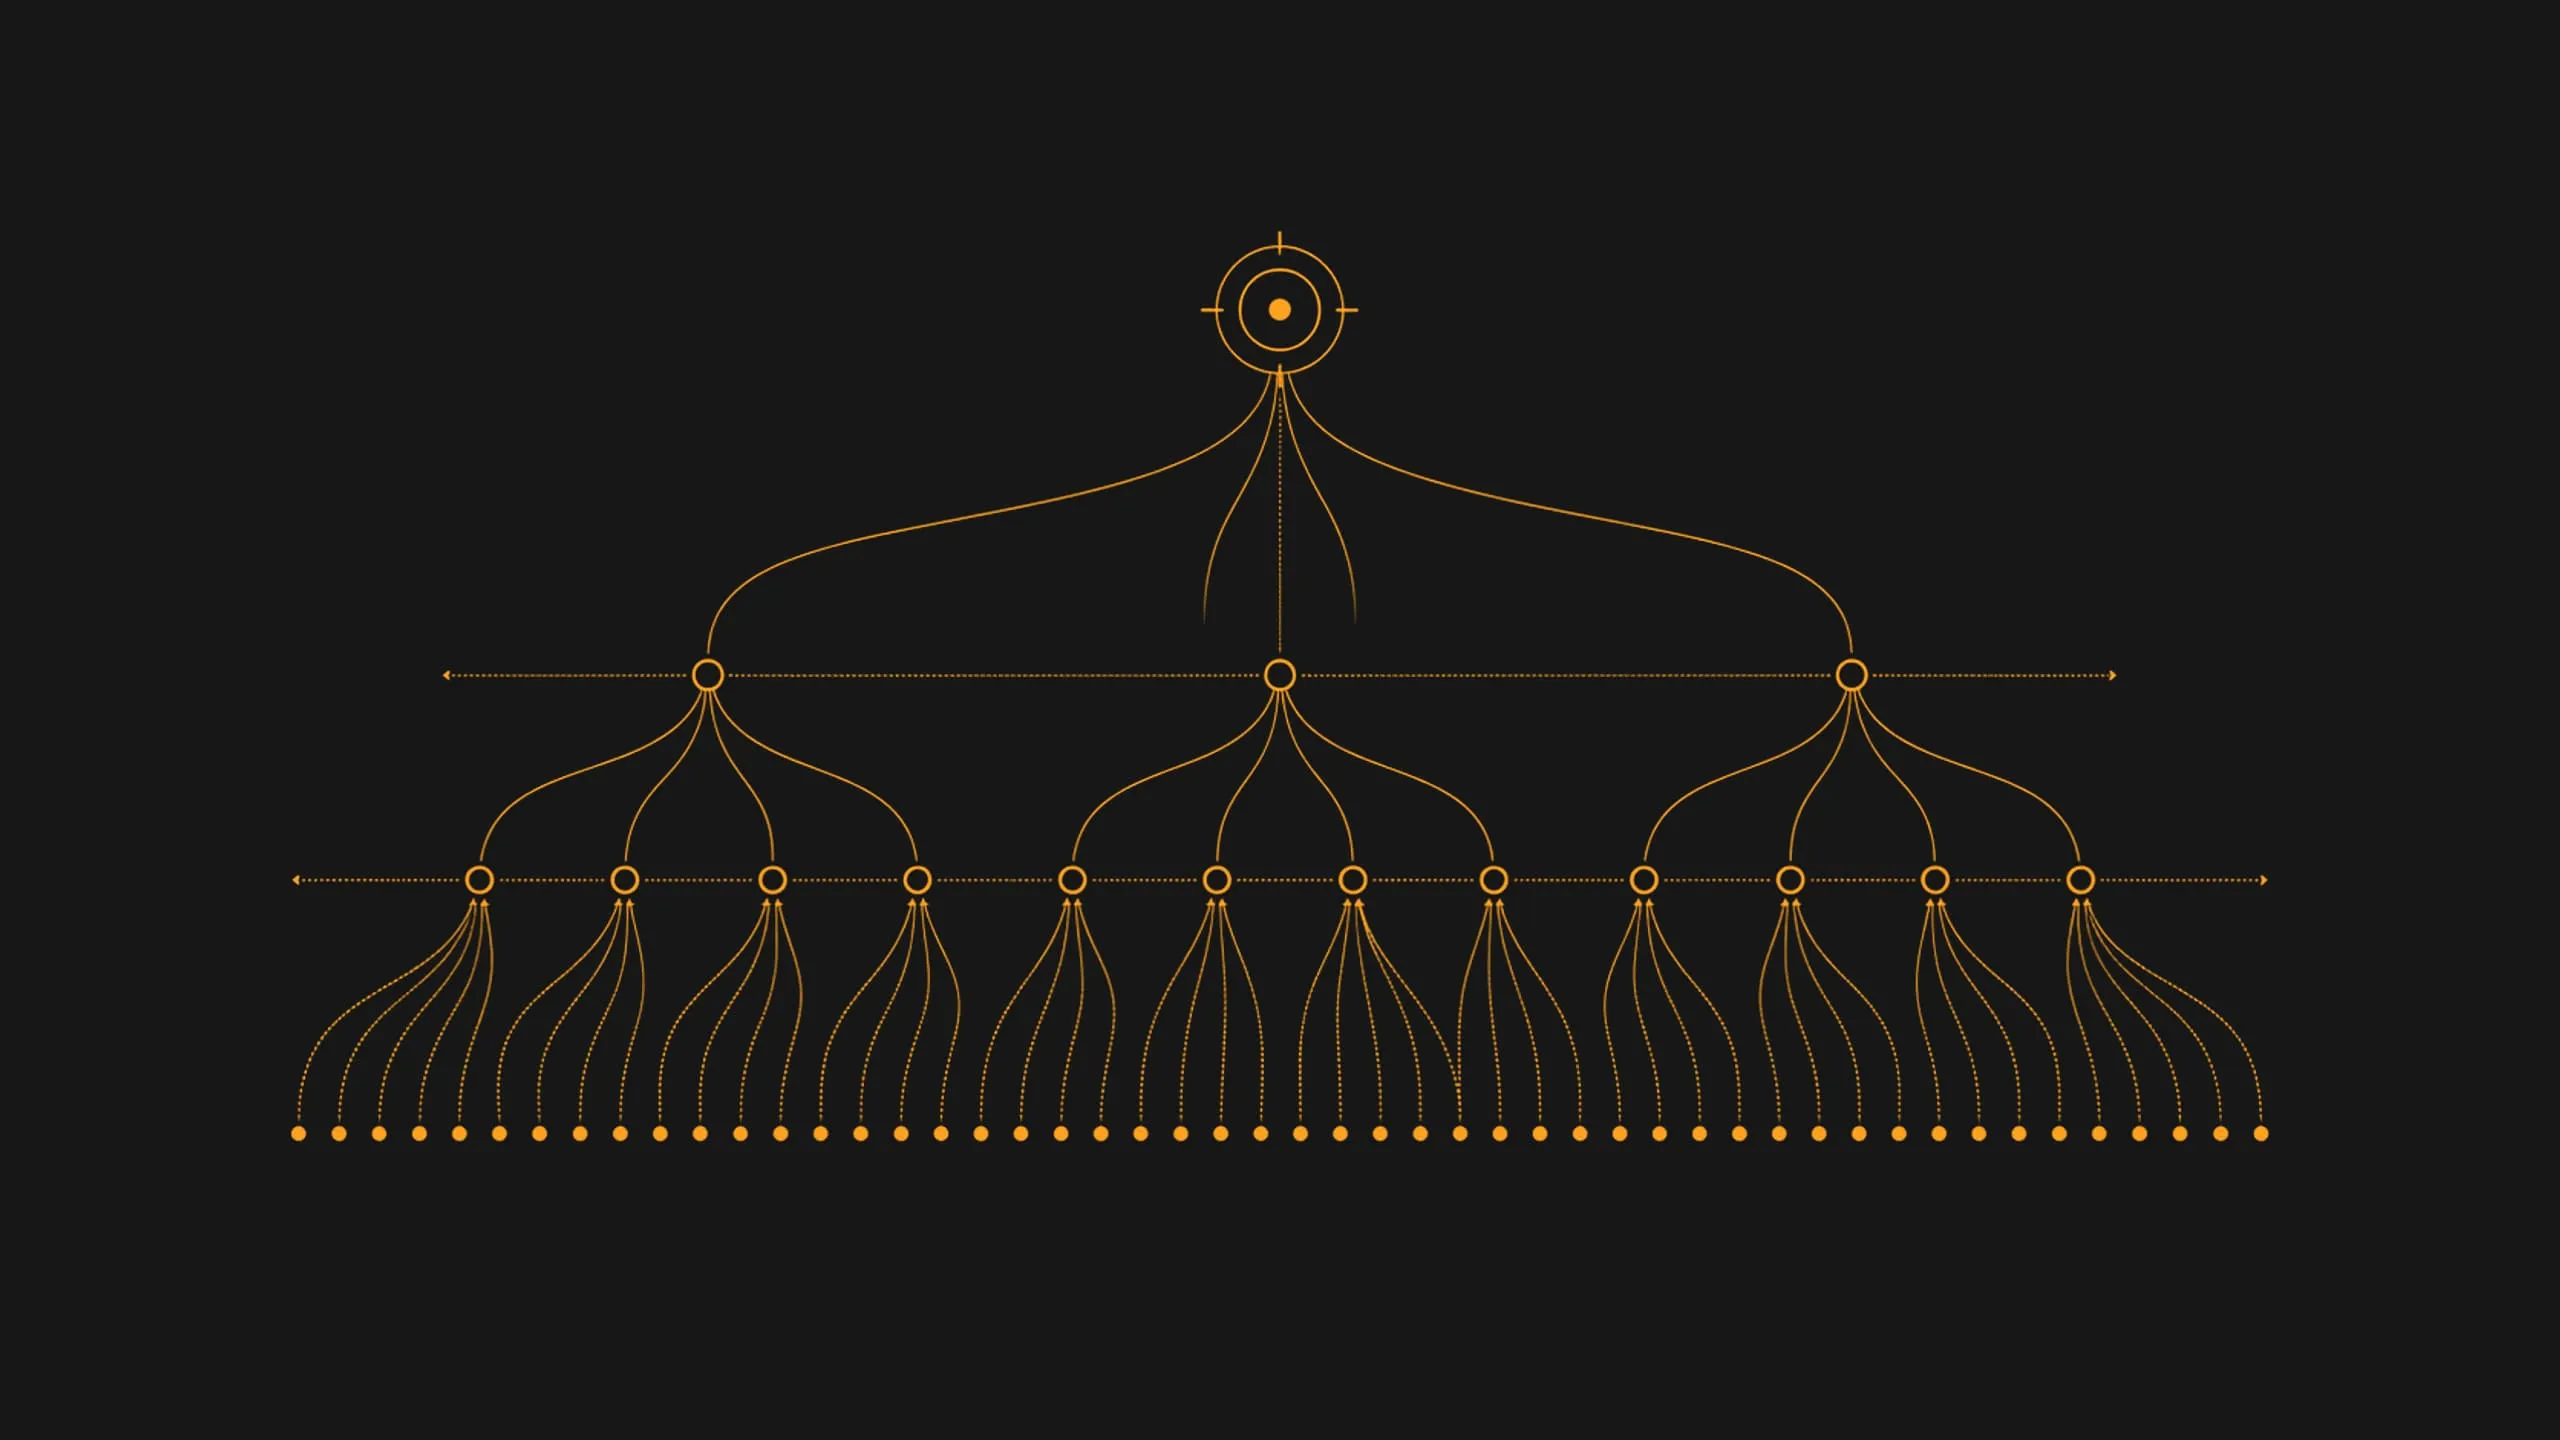
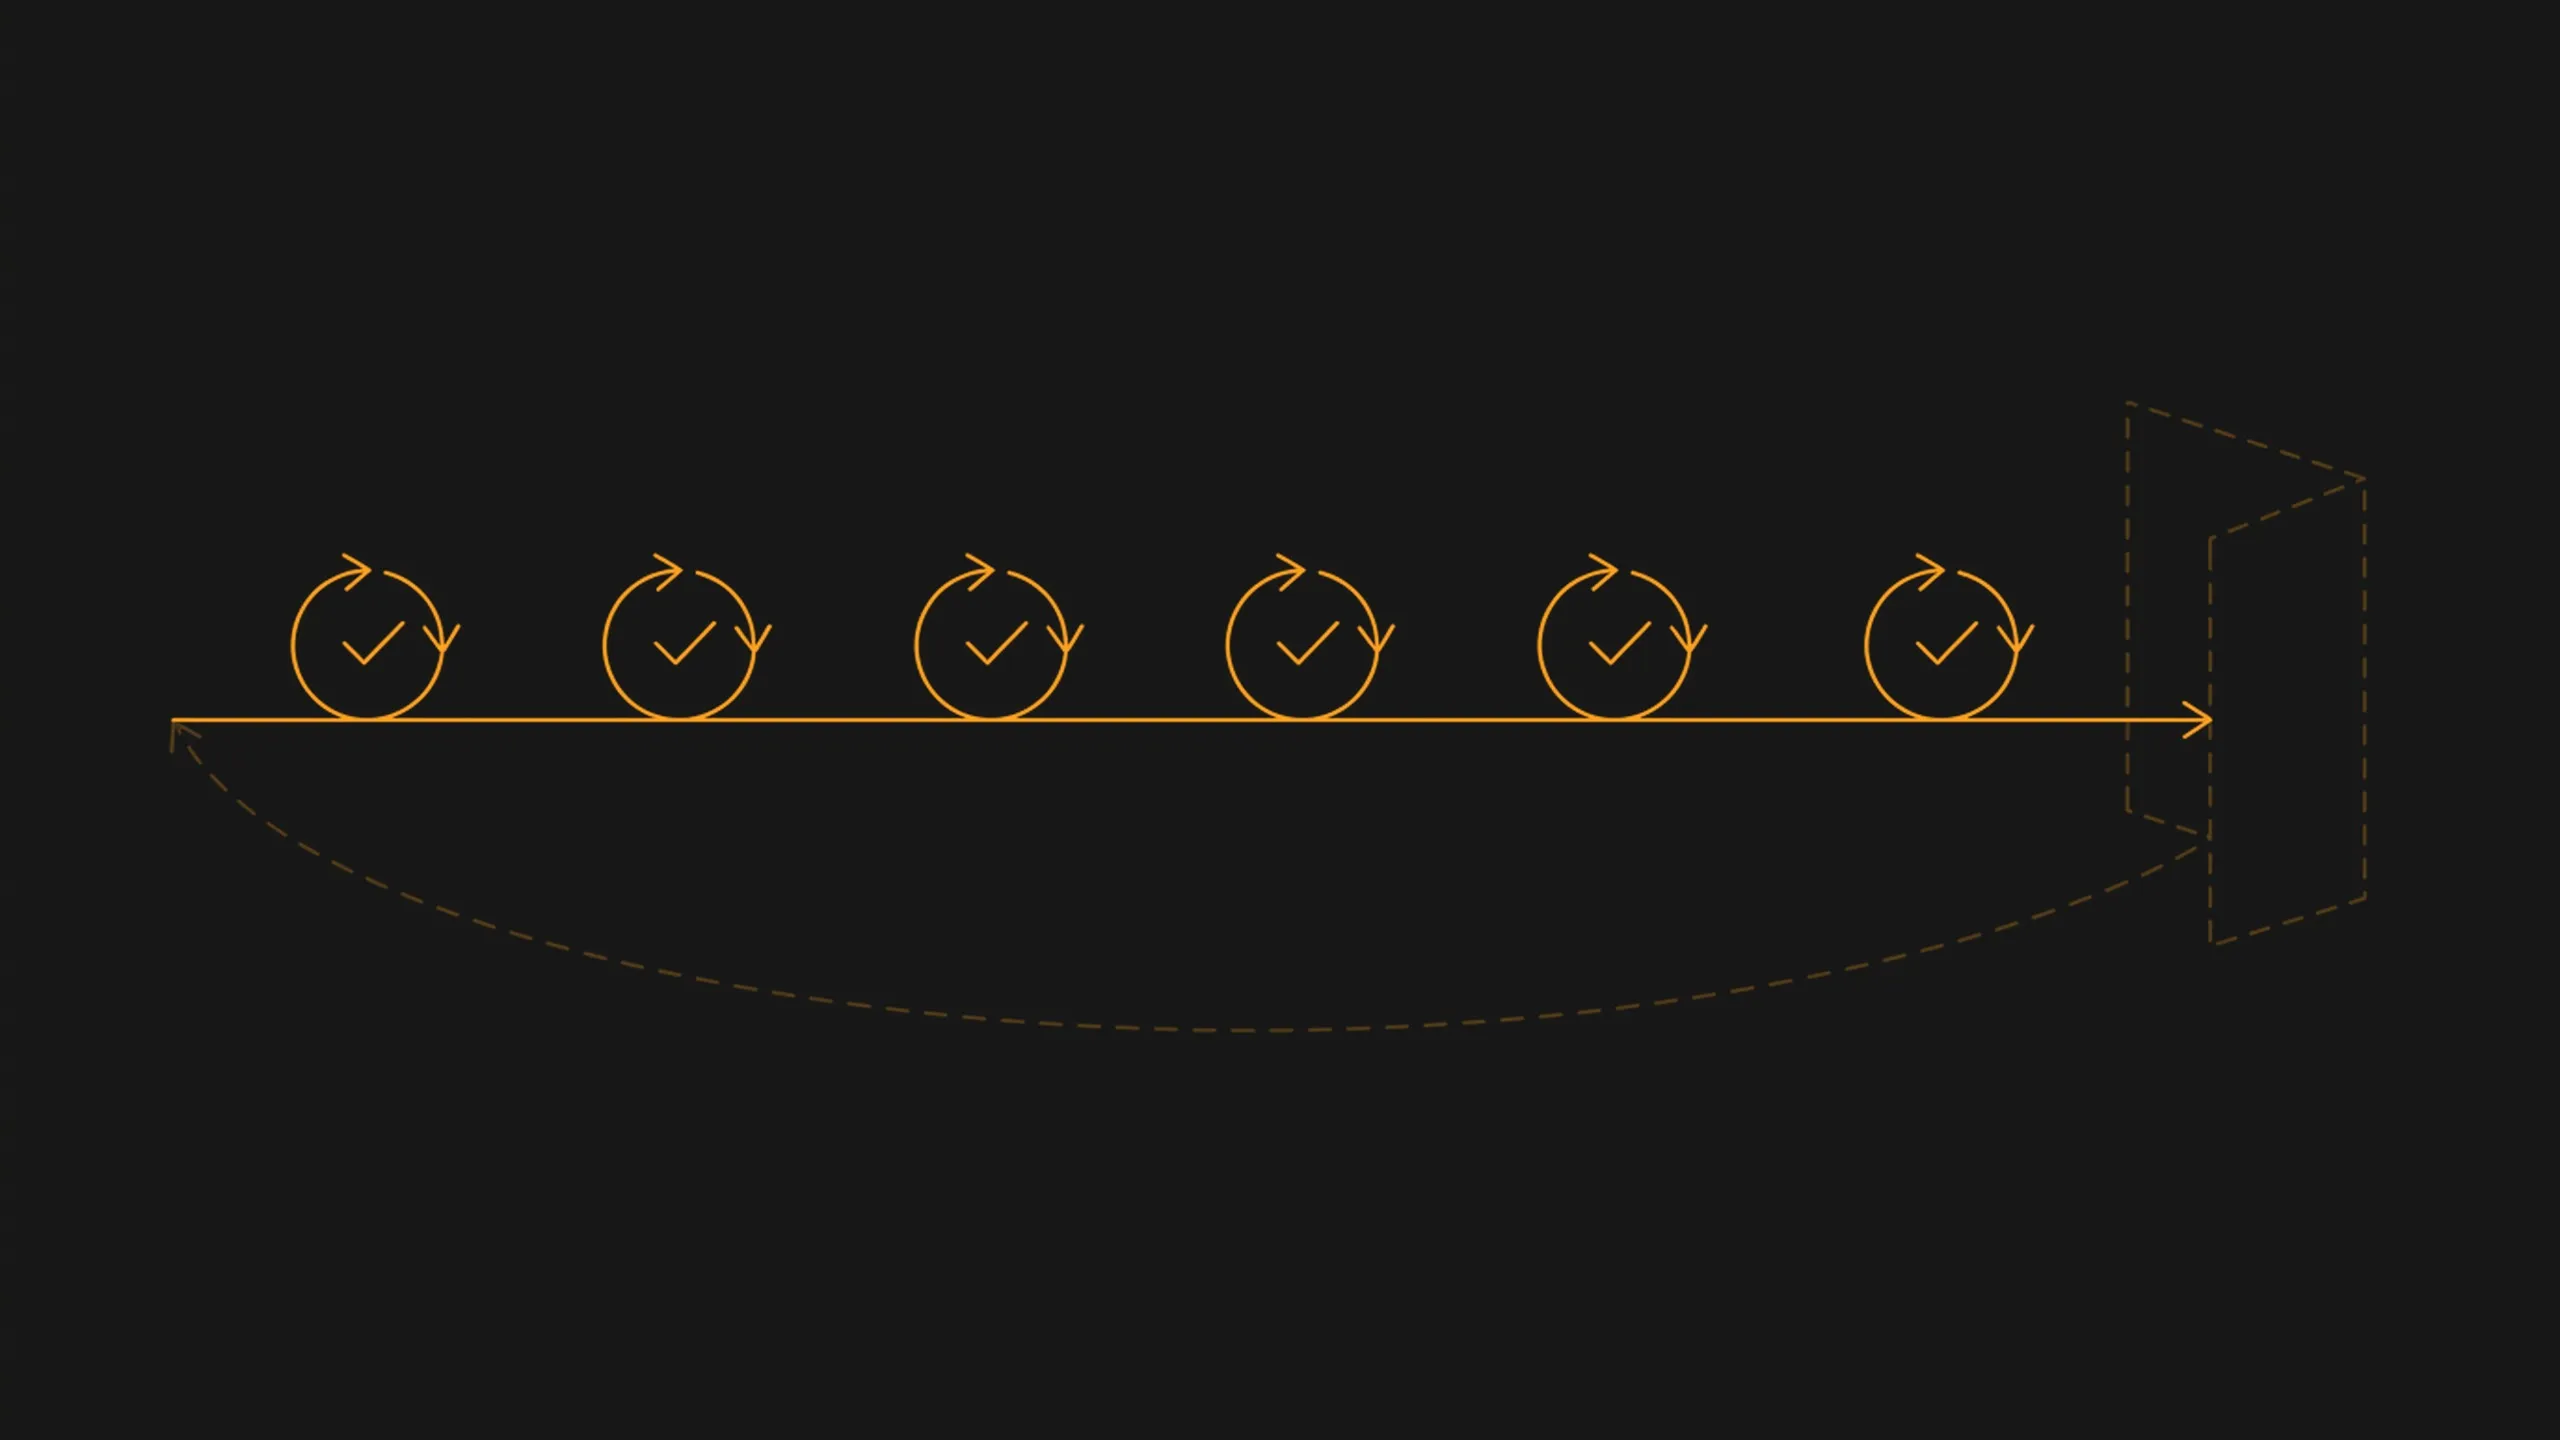
Was agentischen Output härtet, ist die Dichte kleiner Rückmeldungen im Prozess. Kein Urteil am Schluss, sondern zwanzig kleine unterwegs. Du schmeckst ab, während Du kochst, nicht wenn der Teller beim Gast steht. Kein Grün ohne Schleife. Autonomie nur so weit, wie die Rückmeldung reicht.
Konkreter? Hier drei Ideen:
Agenten im Paar. Einer erzeugt Testdaten aus der Anforderung, ein zweiter prüft sie. Entscheidend ist die Unabhängigkeit: Der Prüfer arbeitet nicht gegen die Ausgabe des Erzeugers, sondern gegen eine eigene Referenz. Schema, Wertebereiche, Constraints, Verteilungen aus der Produktion. Und sein Auftrag lautet nicht “sieht gut aus”, sondern “was fehlt”. Grenzwerte, Null, Leerstring, Dubletten. Teilen beide denselben Kontext, erbt der Prüfer die blinden Flecken des Erzeugers.
Hooks. Automatismen, die ohne Dein Zutun auslösen. Ein Accessibility-Check nach jeder Änderung am Frontend. Eine Prüfung vor dem Commit, die bestimmte Muster nicht durchlässt. Eine Regel im Prompt ist eine Bitte. Ein Hook ermöglicht eine harte Prüfung.
Skills. Die Abnahme-Checkliste, die der Agent abarbeiten muss, statt sie zu kennen. Dazu der Eval-Lauf: ein fester Satz Fälle mit erwartetem Ergebnis, der bei jeder Änderung an Prompt, Modell oder Konfiguration durchläuft, mit einer Schwelle, die rot werden darf. Regressionstest für etwas, das nicht deterministisch antwortet.
Natürlich bleiben noch zwei wichtige Stellen: die beiden Enden der Kette.
Vorne das Warum. Was soll das System tun, für wen, was darf auf keinen Fall passieren? Keine Fleißaufgabe für die Doku, sondern die Vorgabe, aus der die Maschinerie ihre Prüfkriterien zieht. Fehlt sie, prüfen Agenten so, wie es ihnen leichtfällt, und nicht entlang des Risikos. So entstehen hundert grüne Häkchen auf Dingen, die nie jemand gefährlich gefunden hätte.
Hinten die Wirklichkeit. Validierung gegen die echte Erwartung, Monitoring im Betrieb, und der Schritt, den die meisten auslassen: Jeder Vorfall aus der Produktion wird sofort nach vorne rückgespielt. Monitoring ist kein Anhängsel am Ende, sondern die Quelle, aus der die agentischen Feedback-Schleifen wachsen.
Also, nicht beim Werkzeug anfangen. Geh mit Deinem Team die Stellen durch, an denen es wehtut oder die Reife sehr hoch ist. Und setz die erste Schleife genau dorthin. Eine reicht für den Anfang. Und dann weiter. Dein Team weiß, wo.