Was sind UML-Metriken?
UML-Metriken sind Kennzahlen, die aus den Diagrammen eines UML-Modells gewonnen werden. Sie zählen, was in jedem UML-Diagramm steckt, und machen so Größe, Komplexität und Qualität eines Softwareentwurfs messbar, lange bevor das System selbst fertig ist. Aus denselben Zahlen lässt sich auch abschätzen, wie viel Entwicklungs- und Testaufwand ein Projekt verursachen wird.
Die Metriken fallen in vier Gruppen. Quantitäts-Metriken zählen Diagramme, Entitäten und Beziehungen. Komplexitäts-Metriken setzen Entitäten und Beziehungen ins Verhältnis. Qualitäts-Metriken vergleichen den Ist-Zustand des Modells mit einem Soll-Zustand. Entwurfsgrößen-Metriken leiten aus dem Modell Größenmaße für die Aufwandsschätzung ab. Diesen Text habe ich gemeinsam mit Harry Sneed geschrieben; er geht auf den Vortrag „Design Metrics for UML Models“ auf der IWSM Mensura 2010 zurück und behält die damalige Zählung von neun Diagrammtypen, die aktuelle UML 2.5.1 unterscheidet 14.
Welche UML-Diagramme gibt es?
Die UML-Spezifikation der Object Management Group (OMG) in der Version 2.5.1 vom Dezember 2017 ordnet 14 UML-Diagrammtypen in zwei Gruppen (Anhang A, Abbildung A.5). Strukturdiagramme zeigen den statischen Aufbau eines Systems, also alles, was unabhängig von der Zeit gilt. Verhaltensdiagramme zeigen das dynamische Verhalten der Objekte, ihre Methoden, ihre Zusammenarbeit, ihre Aktivitäten und Zustandsverläufe. Jede Gruppe umfasst sieben Diagrammtypen:
| Strukturdiagramme | Verhaltensdiagramme |
|---|---|
| Klassendiagramm | Anwendungsfalldiagramm |
| Objektdiagramm | Aktivitätsdiagramm |
| Paketdiagramm | Zustandsdiagramm |
| Komponentendiagramm | Sequenzdiagramm |
| Kompositionsstrukturdiagramm | Kommunikationsdiagramm |
| Verteilungsdiagramm | Interaktionsübersichtsdiagramm |
| Profildiagramm | Zeitverlaufsdiagramm |
Sequenz-, Kommunikations-, Interaktionsübersichts- und Zeitverlaufsdiagramm bilden innerhalb der Verhaltensdiagramme die Untergruppe der Interaktionsdiagramme. Die Grenzen sind dabei nicht starr: Die Spezifikation erlaubt ausdrücklich, Struktur und Verhalten in einem Diagramm zu mischen, etwa einen Zustandsautomaten innerhalb einer internen Struktur.
Für das Messen zählt der Unterschied zwischen Modell und Diagramm. Ein UML-Modell besteht aus Elementen wie Paketen, Klassen und Assoziationen. Ein Diagramm stellt einen Ausschnitt dieses Modells grafisch dar. UML-Metriken zählen beides: die Diagramme und die Modellelemente, die in ihnen vorkommen.
Quantitäts-Metriken: Was in einem UML-Modell gezählt wird
Quantitäts-Metriken sind Zählungen der Diagramm- und Modelltypen, die ein UML-Modell enthält. Die Modelltypen unterteilen sich weiter in Entitäten und Beziehungen.
Gezählt wird jeweils die Anzahl der folgenden neun Diagrammtypen:
- Anwendungsfall-Diagramme
- Aktivitätsdiagramme
- Klassendiagramme
- Sequenzdiagramme
- Interaktionsdiagramme
- Zustandsdiagramme
- Komponentendiagramme
- Verteilungsdiagramme
- Entwurfsdiagramme
Dazu kommt die Anzahl der folgenden 17 Entitätstypen:
- Sub-Systeme
- Anwendungsfälle
- Akteure
- Komponenten
- Schnittstellen
- Klassen
- Basis-/Superklassen
- Methoden
- Parameter
- Attribute
- Aktivitäten
- Objekte
- Zustände
- Regeln
- Stereotypen
- Design-Entitäten
- referenzierte Design-Entitäten
Und die Anzahl der folgenden zehn Beziehungstypen:
- Verwendungen
- Assoziationen
- Verallgemeinerungen
- Interaktionen
- Klassenhierarchiestufen
- Methodenaufrufe
- Aktivitätsflüsse
- Zustandsübergänge
- Testfälle
- Design-Beziehungen
Ausgewählt wurden diese Größen, weil sie sich auf die Ziele des objektorientierten Systementwurfs beziehen. Grundlage war die Ziel-Frage-Metrik-Methode von Basili und Rombach.
UML-Komplexitäts-Metriken: Wie komplex ist ein Entwurf?
Komplexitäts-Metriken berechnen ausgewählte Komplexitäten. Komplexität ist hier definiert als das Verhältnis von Entitäten zu Beziehungen. Die Größe einer Menge ergibt sich aus der Anzahl ihrer Elemente, ihre Komplexität aus der Anzahl der Beziehungen zwischen diesen Elementen. Je mehr Verbindungen oder Abhängigkeiten es im Verhältnis zur Anzahl der Elemente gibt, desto größer ist die Komplexität. Für eine einzelne Entität gilt dasselbe: Ihre Komplexität ergibt sich aus der Anzahl ihrer Unterentitäten im Verhältnis zu den Beziehungen zwischen ihnen. Die Gesamtkomplexität des Entwurfs lässt sich damit einfach angeben:
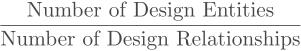
Daraus ergeben sich die folgenden Komplexitätstypen für UML-Modelle.
Komplexität der Objektinteraktion
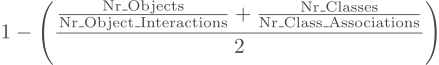
Je mehr Interaktionen zwischen Objekten und je mehr Assoziationen zwischen Klassen es gibt, desto höher ist die Komplexität. So fließen sowohl die abstrakte Ebene der Klassen als auch die physische Ebene der Objekte ein. Das Maß ist eine inverse Kopplungsmetrik. Es beruht auf der empirischen Erkenntnis, dass Systeme mit vielen Abhängigkeiten zwischen ihren Teilen schwer zu warten sind.
Komplexität der Klassenhierarchie
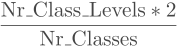
Je mehr Ebenen eine Klassenhierarchie hat, desto abhängiger sind die Klassen der unteren Ebenen von denen der oberen. Tiefe Vererbung steht seit Langem in der Kritik, weil sie die Komplexität erhöht. Die Metrik entspricht der Depth-of-Inheritance-Tree-Metrik (DIT) von Chidamber und Kemerer. Sie stützt sich auf empirische Belege, dass objektorientierte Systeme mit tiefen Vererbungsbäumen (z. B. mehr als drei Ebenen) fehleranfälliger sind als andere.
Komplexität der Klassendaten
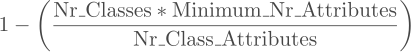
Je mehr Datenattribute eine Klasse hat, desto höher ist ihre Komplexität. Ziel des Entwurfs sind viele Klassen mit jeweils wenigen Datenattributen statt weniger Klassen mit vielen Attributen. Dahinter steht die Annahme, dass sich kleinere Datenmengen leichter testen und pflegen lassen.
Komplexität der Klassenfunktionen
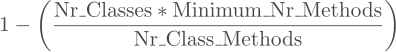
Je mehr Methoden, also Funktionen, eine Klasse hat, desto höher ist ihre Komplexität. Angenommen wird dabei, dass jede Klasse mindestens zwei implizite Funktionen hat: einen Konstruktor und einen Destruktor. Das entspricht der Metrik Weighted Methods per Class (WMC) von Chidamber und Kemerer, wenn jede Methode mit 1 gewichtet wird. Ziel des Entwurfs sind viele Klassen mit möglichst wenigen Funktionen statt weniger Klassen mit vielen Methoden. Die Annahme dahinter: Ein System, dessen Funktionalität in viele kleine Teile zerlegt ist, lässt sich leichter warten und testen.
Komplexität des Objektzustands
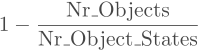
Objekte sind Instanzen einer Klasse, und Objekte haben Zustände. Je mehr Zustände sie haben, desto komplexer sind sie. Eine einfache Klasse ist ein Singleton mit einem Objekt, das einen statischen Zustand hat. Eine komplexe Klasse hat mehrere Objekte mit jeweils mehreren möglichen Zuständen. Weder die CK- noch die MOOD-Metriken berücksichtigen die Zustandskomplexität, obwohl sie zusammen mit der zyklomatischen Komplexität der Methoden ein Haupttreiber des Testaufwands ist. Ziel des Entwurfs sind möglichst wenige Objektzustände, wie viele es tatsächlich werden, bestimmt allerdings die Anwendung. Hat ein Objekt wie ein Konto viele Zustände, etwa eröffnet, ausgeglichen, überzogen, gesperrt oder geschlossen, dann müssen sie alle erzeugt und getestet werden.
Komplexität der Zustandsübergänge
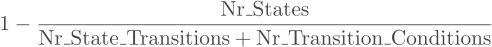
Die Verbindungslinien eines Zustandsdiagramms stellen die Übergänge von einem Zustand in einen anderen dar. Ein Zustand kann beliebig viele Nachfolgezustände haben. Je mehr es sind, desto höher ist die Komplexität des Zustandsübergangsgraphen. Wie beim McCabe-Maß für zyklomatische Komplexität beruht die Zahl auf Kanten und Knoten eines Graphen; McCabe bildet die Differenz, diese Metrik das Verhältnis. Die Knoten sind hier Zustände statt Anweisungen, die Kanten Transitionen statt Verzweigungen. Ziel des Entwurfs sind möglichst wenige Transitionen, denn jeder Zustandsübergang muss mindestens einmal getestet werden, und das treibt die Testkosten.
Komplexität des Aktivitäts-Kontrollflusses
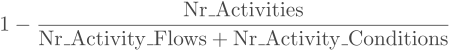
Die Verbindungslinien eines Aktivitätsdiagramms stellen den Kontrollfluss von einer Aktivität zur nächsten dar. Diese Flüsse können bedingt oder unbedingt sein. Bedingte Flüsse erhöhen die Komplexität des modellierten Prozesses. Eine Aktivität kann beliebig viele Folgeaktivitäten haben. Je mehr es sind und je mehr davon bedingt sind, desto höher ist die Komplexität des Prozesses.
Komplexität der Anwendungsfälle
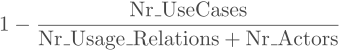
Anwendungsfälle, wie Ivar Jacobson sie geprägt hat, sind Instanzen der Systemnutzung. Ein Benutzer oder Systemakteur ruft einen Anwendungsfall auf. Die Beziehungen zwischen Use Cases können Verschiedenes bedeuten: Verwendung, Erweiterung, Einschließen oder Erben. Je mehr Beziehungen es gibt, desto höher ist die Komplexität der Nutzung. Ziel des Entwurfs ist es, die Abhängigkeiten zwischen Anwendungsfällen zu begrenzen. Braucht die Anwendung sie jedoch, müssen sie auch modelliert werden. Sonst wird die Komplexität nur in eine andere Schicht verschoben.
Komplexität der Akteur-Interaktion
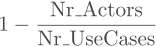
Systemakteure lösen die Anwendungsfälle aus, jeder Akteur einen oder mehrere. Je mehr Anwendungsfälle auf einen Akteur kommen, desto komplexer ist die Beziehung zwischen Akteuren und System. Aus Sicht eines Akteurs ist ein System komplex, wenn er sich mit vielen Anwendungsfällen auseinandersetzen muss. Ein System mit nur einem Anwendungsfall pro Akteur ist einfach, weil es entlang der Akteure partitioniert ist. Ziel des Entwurfs ist es, die Anzahl der Anwendungsfälle pro Akteur zu begrenzen. Mehr Akteure erhöhen natürlich die Größe des Systems in Use-Case-Points.
Gesamtkomplexität des Entwurfs
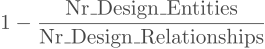
Die Gesamtkomplexität des Entwurfs ergibt sich aus dem Verhältnis zwischen der Summe aller Design-Entitäten und der Summe aller Design-Beziehungen.
Ein Entwurf, in dem jede Entität nur wenige Beziehungen hat, gilt als weniger komplex als einer, in dem die Anzahl der Beziehungen pro Entität hoch ist. Darin spiegelt sich die Definition von Komplexität über das Verhältnis zwischen der Anzahl der Elemente einer Menge und den Beziehungen zwischen ihnen. Mehr Elemente machen die Menge größer, mehr Beziehungen machen sie komplexer. Ziel des Entwurfs ist es, die Beziehungen zwischen den Entwurfsobjekten zu minimieren.
UML-Qualitäts-Metriken: Wie misst man die Qualität eines UML-Modells?
Die Metriken zur Entwurfsqualität berechnen ausgewählte Qualitäten. Qualität ist hier definiert als das Verhältnis zwischen dem Zustand, in dem sich das Modell befindet, und dem Zustand, in dem es sich befinden sollte. Die Messung setzt also einen Standard für das UML-Modell voraus, mit dem der Ist-Zustand verglichen wird. Je näher das Modell an diesem Standard liegt, desto höher ist seine Qualität. Vereinfacht lässt sich die Gesamtentwurfsqualität als Verhältnis ausdrücken:
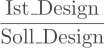
Die Obergrenze der Metrik ist 1. Überschreitet der Ist-Wert den Soll-Wert, wurde das Qualitätsziel übertroffen. Ein Quotient von 0,5 zeigt eine mittlere Qualität an. Dabei gilt: Qualität ist relativ. Für sich genommen sagt der Quotient wenig aus. Im Vergleich mit dem Quotienten eines anderen Entwurfs, der auf genau dieselbe Weise berechnet wurde, zeigt er aber, welcher Entwurf in Bezug auf das gemessene Qualitätsmerkmal besser oder schlechter ist. Da es keine absolute Qualitätsskala gibt, lässt sich die Qualität eines Systementwurfs nur relativ zu einem anderen beurteilen. Für UML-Modelle wurden die folgenden Qualitätsmerkmale ausgewählt.
Grad der Klassenkopplung
Die Klassenkopplung ist der Kehrwert der Interaktionskomplexität. Sie wird so berechnet:
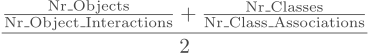
Je mehr Interaktionen und Assoziationen es zwischen Objekten und Klassen gibt, desto stärker hängen sie voneinander ab. Diese gegenseitige Abhängigkeit heißt Kopplung. Stark gekoppelte Klassen haben einen größeren Wirkungsbereich: Werden sie geändert, sind mit höherer Wahrscheinlichkeit auch andere Klassen betroffen. Ziel des Entwurfs sind möglichst wenige Abhängigkeiten, also eine geringe Kopplung. Das Merkmal beruht auf der empirischen Erkenntnis, dass hohe Kopplung mit einem größeren Auswirkungsbereich, einer höheren Fehlerrate und höherem Wartungsaufwand einhergeht.
Grad der Klassenkohäsion
Die Klassenkohäsion wird über die Anzahl der Datenattribute einer Klasse im Verhältnis zur Anzahl ihrer Methoden gemessen:
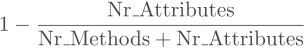
Kohäsion bezeichnet den Grad, in dem die Funktionen eines Moduls zusammengehören. Funktionen gehören zusammen, wenn sie dieselben Daten verarbeiten, man kann das als Datenkopplung bezeichnen. Je weniger Daten von denselben Funktionen verwendet werden, desto besser. Klassen mit hoher Kohäsion haben viele Methoden und wenige Attribute, Klassen mit vielen Attributen und wenigen Methoden eine geringere. Ziel des Entwurfs sind möglichst wenige gemeinsame Attribute für gleiche Methoden. Dem Merkmal liegt die Hypothese zugrunde, dass hohe Kohäsion mit hoher Wartbarkeit einhergeht. Bewiesen wurde diese Hypothese nie.
Grad der Modularität
Modularität ist ein Maß für die Zerlegung. Sie drückt aus, wie weit ein großes System in viele kleine Teile zerlegt wurde. Die Theorie dahinter: Mit kleineren Code-Einheiten lässt sich leichter umgehen. Die Modularität von Klassen ergibt sich aus der Anzahl ihrer Attribute und Methoden:
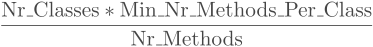
Weit verbreitet ist die Überzeugung, dass viele kleine Code-Einheiten leichter zu ändern sind als wenige große, und zahlreiche Feldversuche stützen sie. Das alte römische Prinzip „divide et impera“ gilt auch für Software. Dass kleinere Module zwangsläufig fehlerfreier sind, ist dagegen nicht bewiesen. Die Rechtfertigung für Modularität liegt deshalb in der leichteren Änderbarkeit. Im Code lässt sich Modularität bestimmen, indem man die tatsächliche Größe der Code-Einheiten in Anweisungen mit einer vorgegebenen Maximalgröße vergleicht. In einem objektorientierten Entwurf sind die elementaren Einheiten die Methoden, und die Anzahl der Methoden pro Klasse sollte eine definierte Grenze nicht überschreiten. Für die Modularität eines UML-Modells empfiehlt es sich, die Gesamtzahl der Methoden mit der minimalen Anzahl von Methoden pro Klasse mal der Gesamtzahl der Klassen zu vergleichen. Ziel des Entwurfs sind so wenige Methoden pro Klasse wie möglich. Das ermutigt Designer, mehr und kleinere Klassen zu bauen.
Grad der Portabilität
Portabilität auf Entwurfsebene beschreibt, wie leicht sich die Architektur in eine andere Umgebung übertragen lässt. Sie hängt davon ab, wie der Entwurf in Pakete aufgeteilt ist. Viele kleine Pakete lassen sich leichter portieren als wenige große, deshalb sollten Pakete so klein wie möglich bleiben. Die Paketgröße ergibt sich aus der Anzahl der Klassen pro Paket. Gleichzeitig sollten Pakete nur wenige Abhängigkeiten zu ihrer Umgebung haben: Je weniger Schnittstellen ein Paket hat, desto besser. Die Portabilität eines Systems wird so ausgedrückt:
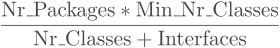
Die Begründung geht in dieselbe Richtung wie bei der Modularität. Die Anzahl der Klassen pro Paket sollte eine bestimmte Grenze nicht überschreiten, und ein Paket sollte nur eine begrenzte Anzahl von Schnittstellen zu seiner Umgebung haben, denn genau diese Schnittstellen binden es an die Umgebung. Ziel des Entwurfs sind Pakete mit möglichst wenigen Klassen und Schnittstellen.
Grad der Wiederverwendbarkeit
Wiederverwendbarkeit beschreibt, wie leicht sich Code- oder Entwurfseinheiten aus ihrer ursprünglichen Umgebung herauslösen und in eine andere verpflanzen lassen. Dafür braucht es möglichst wenige Abhängigkeiten zwischen den Entwurfseinheiten. In der UML werden Abhängigkeiten als Generalisierungen, Assoziationen und Interaktionen ausgedrückt. Der Grad der Abhängigkeit berechnet sich daher so:
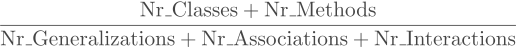
Je mehr Generalisierungen, Assoziationen und Interaktionen es gibt, desto schwieriger lassen sich einzelne Klassen und Methoden aus der aktuellen Architektur lösen und anderswo wiederverwenden. Wie bei Pflanzen, deren Wurzeln sich mit denen der Nachbarn verflochten haben: Wer sie umsetzen will, muss die Wurzeln durchtrennen. Bei Software ist es nicht anders. Vererbung und Interaktion mit anderen Klassen erhöhen den Grad der Abhängigkeit und senken die Wiederverwendbarkeit. Ziel des Entwurfs sind so wenige Abhängigkeiten wie möglich.
Grad der Testbarkeit
Testbarkeit misst den Aufwand, den der Test eines Systems im Verhältnis zu seiner Größe erfordert. Je weniger Aufwand nötig ist, desto höher ist die Testbarkeit. Der Testaufwand ergibt sich aus der Anzahl der Testfälle und der Breite der Schnittstellen, gemessen als Anzahl der Parameter pro Schnittstelle. Die Gleichung lautet:
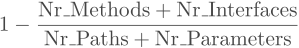
Die Anzahl der benötigten Testfälle ergibt sich aus den möglichen Pfaden durch die Systemarchitektur. Um eine Schnittstelle zu testen, müssen ihre Parameter in verschiedenen Kombinationen belegt werden. Je mehr Parameter, desto mehr Kombinationen. Die Praxis zeigt, dass sich mehrere schmale Schnittstellen mit wenigen Parametern leichter testen lassen als wenige breite mit vielen Parametern. Den Testaufwand bestimmt also neben den Testfällen auch die Breite der Schnittstellen. Ziel des Entwurfs ist eine Architektur, die sich mit möglichst geringem Aufwand testen lässt. Das gelingt, indem man die möglichen Pfade durch das System minimiert und die Schnittstellen modularisiert.
Grad der Konformität
Konformität misst, wie weit Entwurfsregeln eingehalten werden. Jedes Softwareprojekt sollte eine Konvention für die Benennung von Entitäten haben, mit vorgeschriebenen Namen für Datenattribute und Schnittstellen ebenso wie für Klassen und Methoden. Die Projektleitung ist dafür verantwortlich, diese Namenskonventionen bereitzustellen, die Qualitätssicherung dafür, dass sie eingehalten werden. Die Gleichung ist sehr einfach:
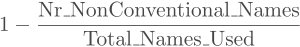
Unverständliche Namen sind das größte Hindernis für das Verständnis von Code. Egal wie gut er strukturiert ist: Solange Daten- und Prozedurnamen unklar sind, bleibt der Code unverständlich. Die Namen aus den UML-Diagrammen landen im Code. Sie sollten deshalb sorgfältig gewählt sein und einer strengen Namenskonvention folgen. Ziel ist es, dass Designer in ihrer Entwurfsdokumentation sinnvolle, standardisierte Namen verwenden.
Grad der Konsistenz
Konsistenz im Entwurf heißt, dass die Entwurfsdokumente zueinander passen. Ein Sequenzdiagramm sollte keine Klasse oder Methode referenzieren, die im Klassendiagramm fehlt. Das Gleiche gilt für die Methoden in den Aktivitätsdiagrammen: Sie sollten mit denen in den Sequenz- und Klassendiagrammen übereinstimmen. Und die Parameter, die in Sequenzdiagrammen übergeben werden, sollten dieselben sein, die den Methoden in den Klassendiagrammen zugeordnet sind. Die Klassendiagramme sind also die Basis, alle anderen Diagramme sollten zu ihnen passen. Tun sie es nicht, liegt ein Konsistenzproblem vor. Die Gleichung lautet:
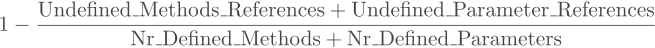
Beim Messen der Konsistenz stößt man auf eine der größten Schwächen der UML: Sie ist in sich selbst inkonsistent. Denn sie wurde aus vielen Entwurfsdiagrammtypen unterschiedlicher Herkunft zusammengesetzt. Zustands-, Aktivitäts- und Kollaborationsdiagramme gab es lange vor der UML, sie stammen aus dem strukturierten Entwurf. Die Grundlage des objektorientierten Designs ist das Klassendiagramm von Grady Booch. Use-Case- und Sequenzdiagramme hat Ivar Jacobson später hinzugefügt. Ein einheitliches Design der Sprache UML gab es also nie. Designer können die Diagrammtypen völlig unabhängig voneinander erstellen. Prüft das UML-Werkzeug das nicht, entstehen inkonsistente Namen. Ziel des Entwurfs ist deshalb ein gemeinsamer Namensraum für alle Diagramme, in dem alle referenzierten Methoden, Parameter und Attribute in den Klassendiagrammen definiert sind.
Grad der Vollständigkeit
Vollständigkeit könnte bedeuten, dass die Entwurfsdokumentation alle Anforderungen und Anwendungsfälle aus dem Anforderungsdokument abdeckt. Um das zu prüfen, bräuchte es eine Verknüpfung mit dem Anforderungs-Repository, und im Entwurf müssten dieselben Namen für dieselben Entitäten stehen wie im Anforderungstext. Davon ist die Praxis weit entfernt. Kaum ein IT-Projekt hat einen gemeinsamen Namensraum für alle seine Dokumente, geschweige denn ein gemeinsames Repository. Gemessen wird deshalb nur die formale Vollständigkeit, also ob alle geforderten Diagramme vorhanden sind. Der Grad der Vollständigkeit ist eine einfache Relation von fertigen zu benötigten Dokumenten:
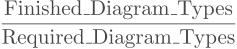
Ziel des Entwurfs ist, dass alle für das Projekt erforderlichen Diagrammtypen tatsächlich vorliegen. In der Testpraxis von UML-Projekten zeigt sich immer wieder: Das Design wird nie abgeschlossen. Der Druck, mit dem Codieren zu beginnen, ist zu groß, und sobald codiert wird, veraltet das Design.
Grad der Übereinstimmung
Die entscheidende Qualität eines Systementwurfs ist, dass er die Anforderungen erfüllt. Nicht alles, was gemessen wird, ist wichtig, und vieles, was wichtig ist, lässt sich nicht messen. Hier trifft das sicher zu. Ob die Anforderungen der Anwender wirklich erfüllt sind, zeigt erst der Test des Endprodukts gegen die Anforderungen. Am Entwurf lassen sich höchstens Akteure und Anwendungsfälle mit denen in den Anforderungen vergleichen. Jede funktionale Anforderung sollte im Anforderungsdokument einem Anwendungsfall zugeordnet sein. Dann decken die Anwendungsfälle alle funktionalen Anforderungen ab. Stimmt die Anzahl der Use Cases im Entwurf mit der in den Anforderungen überein, gilt der Entwurf als konform, zumindest formal. Das drückt dieser Koeffizient aus:
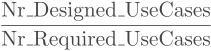
Wurden mehr Anwendungsfälle entworfen als gefordert, ist die Lösung größer als das Problem. Wurden weniger entworfen, ist der Entwurf offensichtlich nicht konform. Ziel ist ein Entwurf, der alle Anforderungen abdeckt, zumindest auf der Ebene der Anwendungsfälle.
UML-Entwurfsgrößen-Metriken: Aufwand aus dem Entwurf schätzen
Entwurfsgrößen-Metriken sind berechnete Werte, die die Größe eines Systems darstellen. Gemessen wird dabei das Modell des Systems, denn das System selbst ist erst messbar, wenn es fertig ist. Größenmaße braucht man aber früh, um den Aufwand für Entwicklung und Test vorherzusagen. Sie lassen sich aus den Anforderungen ableiten, indem man die Anforderungstexte analysiert, oder zur Entwurfszeit aus den Entwurfsdiagrammen. Beide Messungen sind nur so gut wie die Anforderungen oder der Entwurf, die gemessen werden. Weil der Entwurf detaillierter und eher vollständig ist, liefert die Messung der Entwurfsgröße die zuverlässigere Schätzung. Vollständig ist der Entwurf allerdings erst viel später als die Anforderungen. Die erste Kostenschätzung muss deshalb auf den Anforderungen beruhen. Übersteigt die entwurfsbasierte Schätzung die ursprüngliche, muss Funktionalität gestrichen werden, also weniger wichtige Anwendungsfälle und Objekte. Weicht sie deutlich ab, muss das Projekt gestoppt und über Zeit und Kosten neu verhandelt werden. In jedem Fall sollte das Projekt neu kalkuliert werden, sobald der Entwurf fertig ist.
Es gibt verschiedene Methoden, Software-Projektkosten zu schätzen, und jede beruht auf einer anderen Größenmetrik. Ein Projekt sollte immer mit mindestens drei verschiedenen Methoden geschätzt werden. Deshalb stehen hier fünf Größenmaße zur Auswahl:
- Daten-Punkte
- Funktions-Punkte
- Objekt-Punkte
- Use-Case-Points
- Testfälle
Daten-Punkte
Data-Points ist ein Größenmaß, das Sneed 1990 veröffentlicht hat. Es misst die Größe eines Systems allein auf Basis seines Datenmodells, bezieht aber die Benutzerschnittstellen mit ein. Entstanden ist es in der Softwareentwicklung der 4. Generation, in der Anwendungen um ein bestehendes Datenmodell herum gebaut werden. In der UML steckt das Datenmodell in den Klassendiagrammen, die Benutzerschnittstellen lassen sich in den Use-Case-Diagrammen erkennen. Daraus ergibt sich diese Berechnung der Datenpunkte:
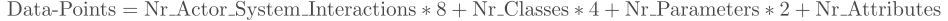
Funktions-Punkte
Function-Points ist ein Größenmaß, das Albrecht 1979 bei IBM eingeführt hat. Es misst die Größe eines Systems anhand seiner Eingaben und Ausgaben sowie seiner Datendateien und Schnittstellen. Eingaben werden mit 3 bis 6 gewichtet, Ausgaben mit 4 bis 7, Dateien mit 7 bis 15 und Systemschnittstellen mit 5 bis 10. Die Methode beruht auf der strukturierten Systemanalyse und dem strukturierten Entwurf. Sie hat sich über die Jahre weiterentwickelt, das grundlegende Zählschema ist aber gleich geblieben. Für objektorientierte Systeme war sie nie gedacht, lässt sich aber anpassen. In einem UML-Entwurf kommen die Klassen den logischen Dateien am nächsten, die Interaktionen zwischen Akteuren und Anwendungsfällen den Benutzereingaben und -ausgaben. Die Schnittstellen zwischen den Klassen lassen sich als Systemschnittstellen interpretieren. Mit dieser groben Annäherung ergibt sich folgende Berechnung der Funktionspunkte:
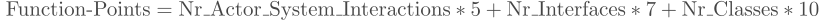
Objekt-Punkte
Object-Points hat Sneed 1996 speziell für die Größenmessung objektorientierter Systeme entwickelt. Die Idee war ein Größenmaß, das sich leicht aus einem Objektentwurf ableiten lässt. Damit passt es sehr gut zum UML-Entwurf, und für ein Objektmodell ist es das naheliegende Größenmaß. Klassen zählen 4 Punkte, Methoden 3 Punkte, Schnittstellen 2 Punkte und Attribute oder Parameter einen Punkt. Die Objekt-Punkte berechnen sich so:
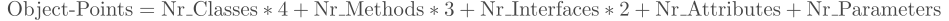
Use-Case-Points
Use-Case-Points hat Gustav Karner 1993 bei der schwedischen Firma Objectory AB eingeführt. Die Idee: die Größe eines Softwaresystems anhand der Anzahl der Akteure sowie der Anzahl und Komplexität der Anwendungsfälle abschätzen. Akteure und Anwendungsfälle werden in drei Stufen eingeteilt: einfach, mittel und schwierig. Akteure werden auf einer Skala von 1 bis 3 bewertet, Anwendungsfälle auf einer Skala von 5 bis 15. Die Summe beider Werte ergibt die unbereinigten Use-Case-Points. Die Methode eignet sich auch, um die Größe eines UML-Entwurfs zu messen, sofern alle Anwendungsfälle und Akteure spezifiziert sind. Hier werden für die Klassifizierung aller Akteure und Anwendungsfälle die Medianwerte verwendet, ergänzt um die Anzahl der Interaktionen zwischen Akteuren und Anwendungsfällen.
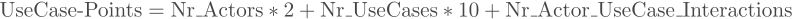
Testfälle
Testfälle hat Sneed erstmals 1978 als Größenmaß verwendet, um den Testaufwand für das Siemens Integrated Transport System (ITS) abzuschätzen. Ziel war, den Modultest auf Basis von Testfällen zu kalkulieren. Ein Testfall entsprach dabei einem Pfad durch das Testobjekt. Viel später wurde die Methode wiederbelebt, um die Kosten für Systemtests zu schätzen. Im Systemtest entspricht ein Testfall einem Pfad durch das System. Er beginnt bei der Interaktion zwischen einem Akteur und dem System und folgt entweder einem Pfad durch die Aktivitätsdiagramme oder durchläuft die Sequenzdiagramme über die Interaktionen zwischen den Klassen. Für jeden Pfad durch die Interaktionsdiagramme und für jeden in den Zustandsdiagrammen spezifizierten Objektzustand sollte es einen Testfall geben. Die Anzahl der Testfälle ergibt sich also aus den Use-Case-Interaktionen mal der Anzahl der Klasseninteraktionen mal der Anzahl der Objektzustände:
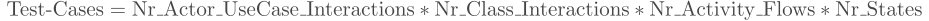
Automatisierte Analyse von UML-Entwürfen mit UMLAudit
Für die Messung von UML-Entwürfen wurde das Werkzeug UMLAudit entwickelt. Es gehörte zum SoftAudit-Toolset für die automatisierte Qualitätssicherung, das auch Analysewerkzeuge für englische und deutsche Anforderungstexte enthielt, dazu für alle führenden Programmiersprachen, die gängigsten Datenbankschemasprachen und mehrere Sprachen zur Definition von Benutzer- und Systemschnittstellen. UMLAudit enthielt einen XML-Parser, der die XML-Dateien las, mit denen das UML-Modellierungswerkzeug die Diagramme darstellt. Dabei wurden Typen, Namen und Beziehungen der Diagramme und Modellinstanzen als Attribute erfasst, die sich über ihre Modelltypen und Namen leicht erkennen lassen. Messobjekt war das XML-Schema des UML-2-Modells mit seinen Modelltypen, wie die OMG sie spezifiziert.
UMLAudit arbeitete in vier Schritten. Zuerst sammelte es die Entwurfstypen und Namen aus den XML-Dateien und legte sie in Tabellen ab. Dann ging es die Tabellen durch und zählte. Im dritten Schritt prüfte es die Namen gegen die Vorlagen für Namenskonventionen. Zuletzt prüfte es die referenzielle Konsistenz, indem es die referenzierten Entitäten mit den definierten verglich. Heraus kamen zwei Berichte:
- ein UML-Mängelbericht und
- ein UML-Metrikenbericht.
Der UML-Mängelbericht war ein nach Diagrammen geordnetes Protokoll von Regelverletzungen und Unstimmigkeiten. Er kannte zwei Arten von Mängeln:
- inkonsistente Referenzen und
- Verstöße gegen Benennungsregeln.
Verwies ein Diagramm, etwa ein Zustands-, Aktivitäts- oder Sequenzdiagramm, auf eine Klasse, eine Methode oder einen Parameter, die im Klassendiagramm nicht definiert waren, meldete UMLAudit eine inkonsistente Referenz. Wich der Name einer Entität von den Benennungsregeln für ihren Entitätstyp ab, meldete es eine Benennungsverletzung. Die Mängel wurden aufsummiert und mit der Anzahl der Modelltypen und Typnamen verglichen, um die Entwurfskonformität zu ermitteln.
Der UML-Metrikenbericht listete die Mengen-, Komplexitäts- und Qualitätsmetriken auf Datei- und Systemebene auf. Die Mengenmetriken waren weiter unterteilt in Diagrammmengen, Strukturmengen, Beziehungsmengen und Größenmetriken.
Was ein Entwurf über das System verrät
Ein Softwaresystem nach seinem Entwurf zu beurteilen, ist wie ein Buch nach seinem Inhaltsverzeichnis zu beurteilen. Ist das Inhaltsverzeichnis sehr feinkörnig, lassen sich Struktur und Aufbau des Buchs beurteilen und Annahmen über den Inhalt treffen. Bei UML ist es dasselbe. Ist der UML-Entwurf bis auf eine detaillierte Ebene ausgearbeitet, lässt sich das System beurteilen und die Kosten lassen sich auf Basis des Entwurfs schätzen. Ist er nur grob, bleibt die Bewertung oberflächlich und die Schätzung unzuverlässig.
Größe, Komplexität und Qualität lassen sich immer nur so genau messen wie die Sache, die man misst. Und UML ist nur ein Modell. Modelle spiegeln die Realität nicht unbedingt wider, tatsächlich tun sie das nur selten. In der Praxis sind UML-Modelle oft unvollständig und inkonsistent, und es ist schwierig, einen Test auf ihnen aufzubauen. Das bleibt das größte Hindernis für modellbasiertes Testen.
Häufig gestellte Fragen
Was ist der Unterschied zwischen einem UML-Modell und einem UML-Diagramm?
Ein UML-Modell besteht aus Modellelementen wie Paketen, Klassen und Assoziationen. Ein UML-Diagramm zeigt davon einen Ausschnitt in grafischer Form. Zu einem Modell gehören meist mehrere Diagramme, und die sollten zueinander passen: Jede Klasse und Methode, die ein Sequenzdiagramm referenziert, sollte im Klassendiagramm definiert sein. Prüft das Werkzeug das nicht, entstehen Widersprüche.
Welche Rolle spielen Beziehungen in einem UML-Modell?
Beziehungen machen aus einzelnen Elementen ein Modell. Zwischen Klassen stehen Assoziationen und Generalisierungen, zwischen Objekten Interaktionen, zwischen Zuständen Übergänge und zwischen Aktivitäten Kontrollflüsse. Ihre Zahl bestimmt die Komplexität. Je mehr Beziehungen auf ein Element kommen, desto komplexer wird der Entwurf, desto stärker sind die Klassen gekoppelt und desto schwerer lassen sie sich wiederverwenden.
Wo steckt das Datenmodell in einem UML-Modell?
In den Klassendiagrammen. Klassen mit ihren Attributen kommen den logischen Dateien eines Systems am nächsten, die Benutzerschnittstellen lassen sich in den Use-Case-Diagrammen erkennen. Auf diesen beiden Quellen baut das Größenmaß Daten-Punkte auf. Es schätzt die Größe eines Systems aus seinem Datenmodell und bezieht die Benutzerschnittstellen mit ein.